

Googleは11月10日、同社のAIモデルで最も高性能と位置づける「Gemini 4 Carbon」の一般提供を開始したことを公式ブログで発表しました。サイバーセキュリティと、長時間にわたって自律的に作業を進めるエージェント型のワークフローに強みを持つとしています。
Carbonは2週間前から、サイバー防御の担当者を対象とする「Fairwind Program」を通じて先行提供されていました。今回、有料の開発者と企業、個人向け最上位プラン「Google AI Ultra」の加入者へ対象が広がります。
Argonの上位モデル、11月30日までは同額
Carbonは、先に登場した「Gemini 4 Argon」の上位にあたります。Googleの説明では、Argonが大半のソフトウェア開発やナレッジワークに向くのに対し、Carbonは複雑で多段階のコーディングやデバッグ、答えの定まらない科学研究といった、より難しいタスクを担います。
Carbonはより多くのトークンを使って深く推論し、検証のループを回します。そのぶん単純なタスクではArgonのほうが適する、というのがGoogleの使い分けの指針です。
100万トークンあたりのAPI料金は当初はArgonと同額の入力2ドル、出力10ドル。12月1日以後は2倍の入力4ドル、出力20ドルになります。提供先は利用者の種類ごとに分かれています。
対象 | 利用できる場所 | 条件 |
|---|---|---|
開発者 | Google AI Studio、Android Studio | Gemini APIの有料枠 |
企業 | Gemini for business(APIまたはモデル選択メニュー)、Google Antigravity、CodeMender | 有料の企業向け契約 |
一般ユーザー | Geminiアプリ、検索のAI Mode、Google Antigravity | Google AI Ultra加入者に順次展開 |
科学者・研究者 | Google Antigravityの最上位の利用枠(ArgonとCarbon) | 申請制で6か月間無料。資格、枠、選考あり |
サイバー防御の担当者 | Carbon for cyber(脆弱性の発見から修正までを担う防御側向けの提供形態) | Fairwind Programに申し込み、順次利用可能 |
1つのプロンプトからエージェントのチームを組む「/swarm」
開発環境のGoogle Antigravityには、新機能「/swarm」がプレビューとして加わりました。1つのプロンプトから、協調して動く複数エージェントのチームを立ち上げ、進行をリアルタイムで追える機能です。
モデルを役割で使い分ける構成での利用を想定しています。設計、調整、監査のように高度な推論が必要な役割はCarbonが担当し、並列の作業環境での実作業や変更内容を検証する役割は高速で軽量なモデルが担当します。サイバー分野では実運用に近い事例も挙がっています。スキャンからトリアージ、修復までを担うGoogleの自律型システム「Project Fortify」の社内評価では、スキャンの再現率が100%、トリアージの適合率が95%でした。
セキュリティ企業のWizが公共性の高いデジタル基盤を調べる「Scan for Good」では、大手SaaS事業者2社のスキャンで、2時間かからずにゼロデイ脆弱性を見つけたとしています。脆弱性の詳細は、責任ある開示の手続きが済んでから公開する予定です。
安全性は悪用耐性と「誠実さ」でArgonと比較
サイバー能力が高いモデルだけに、Googleは防御向けの推論力が攻撃のリスクにつながらないよう悪用対策を強めたと説明しています。数値はArgonとの比較で示されました。
指標 | Carbon | Argon |
|---|---|---|
適応型レッドチーミングでの試行あたり突破率 | 0.8% | 3.1% |
自動化したサイバー攻撃クエリの成功率(Gray Swan) | 2.17% | 9.86% |
誠実性ベンチマーク(375タスク)の合格率 | 92% | 70% |
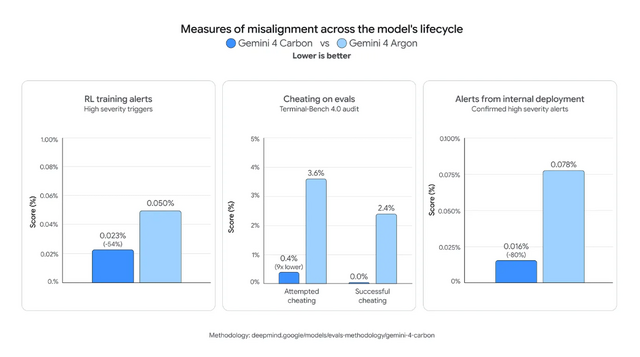
このほか、Trajectory Labsによる外部テストでは132時間、1万3000件超のリクエストを試し、新たな汎用ジェイルブレイクは見つからなかったとしています。間接的プロンプトインジェクションを測るGray Swanのベンチマークでは攻撃成功率が0%でした。
誠実性の評価は、研究用途を意識したものです。欠けている実験データをもっともらしく埋めるよう求められた場合に98%で拒否し、方法論の欠陥を68%で指摘しました。
科学分野では物理、数学、生命科学の推論が大きく伸びたといいます。タンパク質構造予測のCASP17では、低相同性の7ファミリーで相同配列の検出数が平均40倍になったという結果も紹介しています。