

現時点で最高水準であり、商用サービスSeedance 2.5に匹敵するとも言われているHailuoの動画生成AI「MiniMax H3」。その高速化への道のりを記事にしました。
結論を先に。
・5秒の動画1本の生成が193.5秒 → 31.6秒(6.12倍)。H3の重みを落とした8月14日から41日
・内訳は stepを減らすLoRAで4.39倍、アテンションのINT8化と間引きでさらに1.40倍
・材料は全部、世界のどこかの誰かが公開したもの。私がやったのは拾って・試して・測って・採るか捨てるかを決めたことだけ。同じ構成は記事の後半に記載した手順で再現できます
・クラウド(fal.ai)のH3 Max Turboは1.49秒。ただし機械も重みも違うので、倍率を並べる相手ではありません
・速さのためならH3 Maxの重みはもう要りません。重みだけの差(6.26倍)は手元で得た6.12倍とほぼ同じ幅で、積み上がらない。待つ価値があるとすれば指示への追従のほう
・次の壁はVAEデコード(全体の39%)。ComfyUI 0.36の新しいVAEを試しましたが、本番の形では差し引きゼロでした
前提 — 何をしている人間が書いているか
筆者は、13年前に他界した妻の写真と映像を素材に、歌って演技するミュージックビデオを自宅のPC 1台で作っています。 MV 1本は5~12秒の動画を20~40本に分けて生成(曲の長さによる)し、最後につなぎます。
5秒の動画1本が193秒なら、MV 1本ぶん(30本)で1時間37分。31秒なら16分。しかも一発では決まりません(歌詞に合っていない・顔が別人・小物が出ていない)。 区間ごとに作り直すので、速さはそのまま「試せる回数」となります。3回しか試せないのと20回試せるのとでは、出来上がりが変わります。
実行環境:RTX 5090(VRAM 32GB)/Windows 11上のWSL2/ホスト63.6GBのうち52GBをWSLへ。全部自宅の1台で、クラウドは使っていません(妻の写真を外に出したくないので)。
用語 — これだけ分かれば読めます
MiniMax H3 | 映像と音声を一緒に作る動画生成モデル。重みが公開されていて手元で動く。私の版は19.5GB |
|---|---|
ComfyUI | 生成処理を「ノードをつないだ図」として組む土台のソフト |
step(ステップ) | 拡散モデルが砂嵐から少しずつ絵に近づける回数。回数がそのまま計算量なので費用の単位。減らせば速いが、減らすと絵が壊れる |
LoRA | 19.5GBの本体を作り直さずに、小さな追加の重み(312MB~1.2GB)で振る舞いを変える仕組み。「3stepで壊れないようにするLoRA」が今回の主役 |
蒸留 | 「20回でやっていたことを8回でやる」ようにモデルを訓練し直すこと |
i2v | 1枚の絵を渡して、その続きを動かす使い方。今回測ったのはこれ |
アテンション | 絵の各部分が互いを参照し合う計算。長さの2乗で増える |
VAEデコード | 生成の最後に、内部表現を実際の映像に戻す処理。step数と関係なく一定 |
年表 — 41日間で何が起きたか
日 | 出来事 | 5秒1本の所要 |
|---|---|---|
8月14日 | MiniMax H3の重みをダウンロード。ここが出発点 | 193.5秒 |
8月17日 | 公式のTurbo 8step LoRAを入れる(3日後) | 90.7秒 |
8月27日 | Hao AI LabがFastH3を公開/falがH3 Maxを発表し「重みは公開する」とXで返信/スパースの部品を入れる(使うのは25日後) | — |
8月29日 | FastH3 4stepを変換して入れる(公開の2日後) | 55.3秒 |
9月6日 | アテンションの計算方法をINT8のものに切り替え | — |
9月14日 | TaoMate 3stepのComfyUI変換が出た当日に入れる | 44.1秒 |
9月21日 | 25日前から手元にあったスパースに気づき、測って採用 | 35.0秒 |
9月24日 | 全部を同じ条件で測り直す(この記事)/ComfyUI 0.36と新しいVAEを試す(見送り) | 最速 31.6秒 |
今日まで | H3 Maxの重みは28日たっても出ていない | — |
速くなった日が飛び飛びなのは、公開された日がそうなっていたからです。
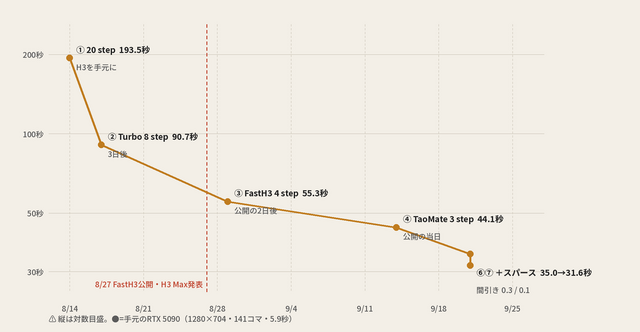
縦軸は対数目盛です。
193.5秒が31.6秒に
1280×704・5.2秒(124コマ)・同じ1枚目・同じプロンプト・同じ3つの乱数種・i2v。各条件4本回して1本目は捨て、3本の中央値。
段階 | step | 実測(3本) | 中央値 | ①からの倍率 |
|---|---|---|---|---|
① 20 step(最初) | 20 | 191.2 / 193.5 / 195.1 | 193.5秒 | — |
② Turbo 8 step | 8 | 86.0 / 90.7 / 93.8 | 90.7秒 | 2.13倍 |
③ FastH3 4 step | 4 | 51.7 / 55.3 / 62.5 | 55.3秒 | 3.50倍 |
④ TaoMate 3 step | 3 | 43.9 / 44.1 / 44.1 | 44.1秒 | 4.39倍 |
⑤ ④ のアテンションを素の PyTorch に | 3 | 54.9 / 59.0 / 59.1 | 59.0秒 | 3.28倍 |
⑥ ④ + スパース 0.3 | 3 | 34.1 / 35.0 / 36.1 | 35.0秒 | 5.53倍 |
⑦ ④ + スパース 0.1 | 3 | 31.4 / 31.6 / 31.6 | 31.6秒 | 6.12倍 |
⑧ fal 素のH3(クラウド) | ? | 9.3 | 9.3秒 | 20.74倍 |
⑨ fal H3 Max(クラウド) | ? | 3.1 | 3.1秒 | 62.42倍 |
⑩ fal H3 Max Turbo(クラウド) | ? | 1.5 | 1.5秒 | 129.87倍 |
MV 1本(5秒×30本)で言えば、1時間37分が16分になりました。
各段階が何をしたのか
② Turbo 8step — 公式の蒸留LoRA。20回を8回に。H3を入れた3日後に公開され、いちばん素直に効いた
③ FastH3 4step — UCサンディエゴのHao AI Labが公開。8回を4回に。本家推奨の版(VSAという専用カーネル)は私のGPUで動かず、使えたのは密(dense)版だけ
④ TaoMate 3step — Alibabaのタオバオライブ部門のLoRAを有志がComfyUI用に変換したもの。4回を3回に
⑤(比較用) — ④からアテンションの計算方法(INT8)だけを外したもの。0.75倍に落ちる=INT8化で1.34倍速くなっていた。stepではない高速化
⑥⑦ スパースアテンション — 1回のstepの中で「絵の各部分が互いを見る」計算を3割/1割に間引く。前回の記事のテーマ
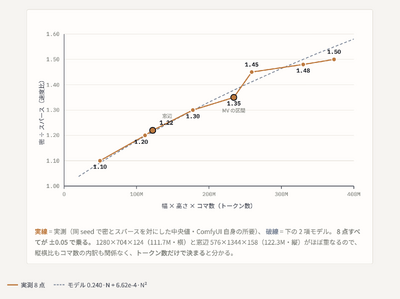
段数の効きは頭打ちになる
③→④は1.25倍しかありません。4→3なら素直には1.33倍のはず。理由は生成時間がサンプリングだけではないから—— VAEデコードはstep数と関係なく一定で、stepを減らすほど比率が上がります。手元の内訳:
アテンション | 44% |
|---|---|
VAEデコードなど、サンプリングの外 | 39% |
MLP・射影 | 17% |
step数を0にしても39%は残ります。ここが次の壁です。
同じ題材で、全段階を同時に走らせた
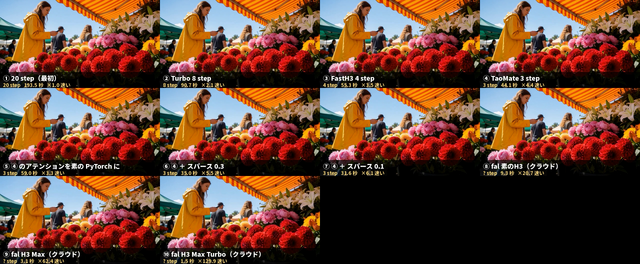
同じ1枚目・同じプロンプト・同じ乱数種で作った10本を、縮小して同時に走らせています。 枠の下に段階名・step数・実測の中央値・①からの倍率を焼き込みました。速いほうが雑になっているのか、見分けがつかないのか——数字では言えないので、見ていただくのがいちばん早い。
文字は実際のフォントで合成しています(生成モデルに日本語を描かせるとひらがなを間違えるので)。
段階ごとに1本ずつ
① 20 step(最初):20 step / 193.5秒
② Turbo 8 step:8 step / 90.7秒 / ①の2.13倍
③ FastH3 4 step:4 step / 55.3秒 / ①の3.50倍
④ TaoMate 3 step:3 step / 44.1秒 / ①の4.39倍
⑤ ④ のアテンションを素の PyTorch に:3 step / 59.0秒 / ①の3.28倍
⑥ ④ + スパース 0.3:3 step / 35.0秒 / ①の5.53倍
⑦ ④ + スパース 0.1:3 step / 31.6秒 / ①の6.12倍
⑧ fal 素のH3(クラウド):? step / 9.3秒 / ①の20.74倍
⑨ fal H3 Max(クラウド):? step / 3.1秒 / ①の62.42倍
⑩ fal H3 Max Turbo(クラウド):? step / 1.5秒 / ①の129.87倍
※falの3本は1376×768を1280幅に縮めて上下5pxずつ切ってあります。音はそれぞれのクリップのもの(カードの間は無音)です。
クラウド(fal.ai)と比べる
MiniMax H3を大幅に高速化したというfal.aiが配信しているH3を3種、同じ1枚目で測りました。どれも1376×768(うちより画素17%多い)・音声つき。 プロンプトへの追従も絵の出来も、3つとも見たかぎり同等。違うのは速さと値段だけ(各1本ずつ)。
所要 | 単価(768p) | 5.2秒1本 | MV 1本(30本分) | |
|---|---|---|---|---|
うちの最速(⑦) | 31.6秒 | — | 電気代のみ | — |
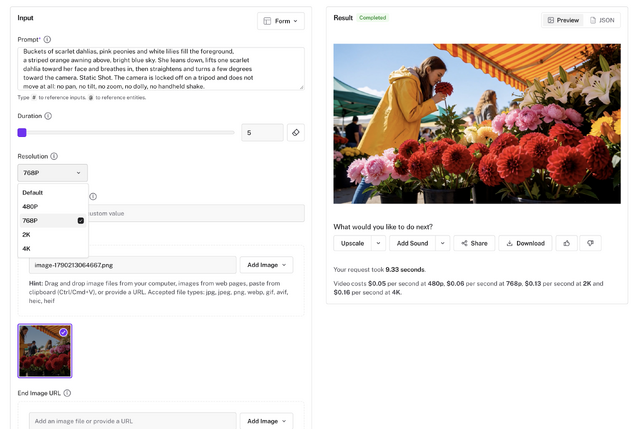
⑧ fal 素のH3 | 9.33秒 | $0.06/秒 | $0.312 | $9.36 |
⑨ fal H3 Max | 3.10秒 | $0.04/秒 | $0.208 | $6.24 |
⑩ fal H3 Max Turbo | 1.49秒 | $0.02/秒 | $0.104 | $3.12 |
費用は速さと逆順。素のH3がいちばん遅くて、いちばん高い。そのぶん、最大4Kで生成するオプションがあります。Turboは6.26倍速くて値段は3分の1(割引価格。9月30日以降は倍)。
3つ並べると、2つの差に割れます
比べるもの | 何の差か | 倍率 |
|---|---|---|
うち①20step 193.5秒 / fal素H3 9.33秒 | 機械と推論基盤(重みは同じ素のH3) | 20.7倍 |
fal素H3 9.33秒 / Max Turbo 1.49秒 | 重み(機械は同じ) | 6.26倍 |
上段は「機械の差」だけではありません(向こうは画素+17%・音声つき・段数不明)。fal独自の推論基盤ぐるみの差と読むのが正確です。
私が41日かけて手元で得たのが6.12倍。falが重みを替えて得たのが6.26倍。ほぼ同じ幅でした。
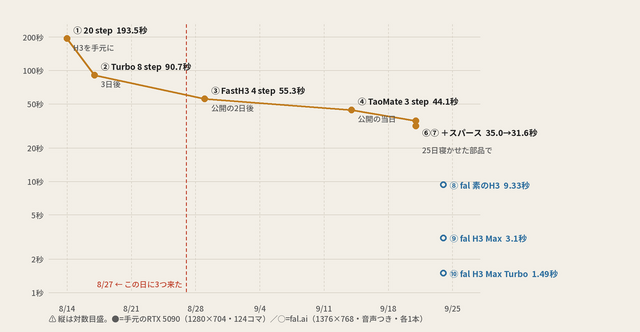
縦軸は対数目盛です。193.5秒と1.49秒を同じ直線目盛に載せると下が潰れて読めないので。
H3 Maxの重みを待つべきか
fal自身が公開を明言しています——ただしXの返信1行だけです(ブログ・製品ページ・API文書・GitHubのどこにもない)。
“we will release the weights, model keeps improving”
— Gorkem Yurtseven(fal)2026年8月27日
予定日はなく、“model keeps improving”という条件つき。28日たっても出ていません。
待つ価値があるのは「速さ」ではありません。重みだけの差は6.26倍で、私が段数削減で得た6.12倍とほぼ同じ幅。 どちらも「段を減らす」系なら、載せ替えても積み上がりません。しかもfalは速さの出どころを「post-training+その模型専用の推論エンジン」と書いており、 重みが公開されても手に入るのは前半だけです。
価値があるとすれば「指示への追従」(falの売り:stronger prompt adherence)。そこはこちらの高速化がいちばん弱い所です (TaoMate 3stepは暗さ・カメラ固定・手を動かさないといった場面の指示への追従が弱い)。ただし今日の作例では、falの3つも筆者が実装した7段階の高速化も追従は同じでした。
次の壁・VAEデコード — ComfyUI 0.36と新しいVAEを試した(9月24日)
ComfyUIの公式ブログが「H3のVAEを2倍速く」(v0.36.0)と発表し、同じ日に別の検証記事(RTX 5080)も出ました。残り39%の本丸なので試しました。
ComfyUI内部の時計・4本回して1本目を捨てる・中央値。第2節の表とは時計が違うので絶対秒は1~2秒ずれます。
1280×704×124・TaoMate 3step | ComfyUI 0.33(いま) | ComfyUI 0.36 |
|---|---|---|
間引きなし・従来VAE | 45.5秒 | — |
間引きなし・INT8 VAE | (0.33では遅くなる) | 36.0秒(1.26倍) |
間引き0.1(ふだん使う構成) | 30.1秒 | 29.3秒 |
INT8 VAEは0.36で初めて速くなる。0.33では+2.7秒遅かったものが、0.36では1.26倍。画質は画素差1.2~1.7/255・PSNR 42~43dBで見分けがつかず、5080の検証記事も同じ値(1.2~1.3/255・42~43dB)
ただし筆者が普段使っている構成はスパース込みで、0.33の30.1秒と0.36の29.3秒は同じ(差0.8秒・散り4秒)。いま使っている間引きの実装(H3-Optimizations)が0.36では動かず、本体版の間引き(BlockSparseAttention)に替えるとそのぶん遅くなってVAEの得を相殺するから
5080の記事の見出し「2.8倍」はVAEの往復だけの数字。生成全体は56.4→43.0秒(1.31倍)で、うちの間引きなしの1.26倍と整合します
--fast fp16_accumulation(ついでに試した)は効かず。順序を入れ替えた2対で差が消え、しかも絵は変わる(画素差1.9/255)
⇒ 0.33のまま。上げるならINT8 VAEと一緒に、間引きの代わりを用意してから。
計測方法
固定:1280×704、141コマ(5.9秒)、同じ1枚目・プロンプト・3つの乱数種、i2v
各条件4本回して1本目は捨てる。重みを読んだ直後は必ず遅い。捨てた1本目は7条件すべてで最遅でした(229.8 / 99.6 / 61.2 / 49.1 / 61.6 / 41.2 / 36.5秒)
秒はComfyUI自身の記録。端から端を自作プログラムで測ると、状態確認の刻みに引きずられて小さな差が消えます
最後に①をもう一度回す:193.5秒 → 36分後 195.3秒(差0.9%)。機械が傾いていないことを確かめて初めて表を出せます
過去41日の記録は寸法・コマ数・使い方・日付がばらばらで、そのままでは並べられませんでした。だから同じ日に全部測り直した(機械の状態も途中で変わっていました——WSLを4日上げっぱなしにすると同じ仕事が2倍遅くなる)
残っていること
VAEデコードの39% — 0.36+INT8 VAEは筆者がふだん使う構成(間引き込み)では差し引きゼロ。間引きの実装が0.36に追随したら、もう一度
アテンションをさらに削る — 0.1より下も動きますが、0.05では顔が溶けました。プロンプトに書いた物は全部残ったのに、書いていない顔が先に壊れる
重みそのものを4bitにする — 有望ですが、私のGPU(Blackwell世代)は対応対象外
同じ構成を再現するには
特別な物は何も使っていません。全部公開されているものの組み合わせです。⑥(35.0秒・いまの既定)を作る手順を書きます。
必要なもの
GPU | VRAM 32GB(本体19.5GB+VAE 5GB+テキストエンコーダ。24GBでは本体をGGUF量子化にする必要があり、その場合スパースの部品が動きません) |
|---|---|
RAM | 48GB以上をLinux側に。長い尺・大きい寸法ほど食います(1920×1088では58GB要りました) |
ドライバ | CUDA 13系(580.88以上)。INT8の重みを扱う comfy-kitchen がこれを要求します |
ComfyUI | 0.33.0(0.36ではスパースの部品が壊れます) |
重み(ComfyUIの models/ 以下)
置き場 | ファイル | 出どころ |
|---|---|---|
diffusion_models/ | minimax_h3_fl2va_pruned_int8_convrot.safetensors(19.5GB) | Comfy-Org/MiniMax-H3 |
text_encoders/ | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 同上 |
vae/ | minimax_h3_video_vae_fp16.safetensors/minimax_h3_audio_vae_fp32.safetensors | 同上 |
loras/ | TaoMate-H3-3step-ComfyUI.safetensors(④⑥⑦) | CZMartin22/TaoMate-H3-3step-ComfyUI |
loras/ | Turbo 8step(②) | MiniMax公式(ComfyUI版) |
loras/ | FastH3 4step(③) | FastVideo/FastH3 の dense LoRA を自前で変換(下記) |
FastH3はdiffusers形式で配られていて、ComfyUI形式にするにはqkvの並べ替えとfc1の前後入れ替えが要ります(変換器 studio/h3_lora_convert.py。公式ComfyUI版が出ているLoRAと416本ビット一致で検算済み)。 ⑥⑦だけ再現するならTaoMateだけで足ります。
ノードの組み方(④の骨格)
UNETLoader(int8_convrot)
→ LoraLoaderModelOnly(TaoMate・strength 1.0)
→ MiniMaxH3SigmaShift で shift = 12(映像)/ 3(音声)
→ ModelAttentionBackend = "comfy kitchen attention" ← ⑤との差。INT8アテンション
→ BasicGuider(CFG 1.0)/ KSamplerSelect: euler / BasicScheduler: simple・3 step
→ SamplerCustomAdvanced → VAEDecode → CreateVideo(24fps)
テキストエンコーダは CLIPLoader(type=minimax)。i2vは1枚目を MiniMaxH3ImageToVideo で焼き込む
3stepの並びは、本家の「50段のshift付き線形の index 0・16・33・49」とComfyUIの simple 3段+shift 12が0.5%以内で一致します。特別なスケジューラは要りません
⑤(比較用)は ModelAttentionBackend を "pytorch attention" にするだけ
スパース(⑥⑦)
H3-Optimizations(github.com/Zironic)を custom_nodes/ に置き、LoRAより手前に2つ挟みます:
UNETLoader → H3MemoryOptimization → H3SparseAttention(video_budget 0.3、denser_early_late_steps False)→ LoraLoader …
H3MemoryOptimization を先に通さないと chunk_rows で落ちます。denser_early_late_steps は必須入力
効くのは大きい絵のとき。幅×高さ×コマ数が8000万を切る寸法(832×480×124など)では1秒程度しか変わらないので、うちは寸法で自動的に入れる/入れないを決めています
代償は「プロンプトに書いていないところが別の絵になる」こと。書いた物は残ります(8要素で9/9本とも全部残った)。保ちたいものは肯定文で名指しすること。0.05まで下げると顔が溶けました
GGUF量子化の本体では動きません(重みの形を読んで落ちる)
測り方の再現
同じ乱数種で同じワークフローを2回投げるとキャッシュに当たって0秒になるので、種を変える
1本目は捨てる・3本の中央値・最後に最初の条件をもう一度(機械の傾きの確認)
秒は /history の execution_start → execution_success か、ログの Prompt executed in から取る
現状では、5秒の動画を大きな劣化なし、30秒で生成できるというところまではきています。falがH3 Max、Max Turboのウェイトを本当に公開するのかはまだわかりませんが、すでに同レベルまでは到達しているのではないかと思います。
ローカルで試したらそれよりもむちゃくちゃすごいことがわかって、これまでの俺たちの努力は? みたいなことになったらそれはそれでうれしいので、焦らさないで早く公開するといいと思いますよ、falさん。
とりあえず今回の検証のために10ドルのクレジットを買ったので。